


L’un des principaux défis en mécanique des fluides numérique est de représenter correctement les phénomènes physiques à différentes échelles de temps et d’espace. De plus, la résolution numérique exacte à chaque échelle est très coûteuse en temps de calcul. L’obtention de solutions fiables passe alors par des simulations effectuées à une échelle grossière mais utilisant des modèles capables de décrire les effets de la physique à très fine échelle. Ces modèles sont utiles par exemple dans l’étude de la combustion, où les réactions chimiques ont lieu dans des zones extrêmement minces appelées fronts de flamme, mais aussi celle des phénomènes turbulents ou encore des écoulements particulaires.
Il existe de nombreux modèles reposant sur des lois physiques, mais leur précision reste en général limitée pour de tels usages, du fait qu’ils s’appuient sur des hypothèses simplificatrices. Une approche récente, rendue possible par les progrès de l’intelligence artificielle, consiste alors à en élaborer de plus exacts, par apprentissage direct sur des données de référence qui proviennent de simulations très détaillées, réalisées chacune sur des domaines de calcul réduits [1].
Cette nouvelle approche a fait l’objet de divers travaux à IFPEN, à commencer dès 2022 par l’apprentissage de lois de forces de trainée sur des particules en suspension. Cela s’est poursuivi par l’apprentissage de modèles de turbulence en mécanique des fluides [2].
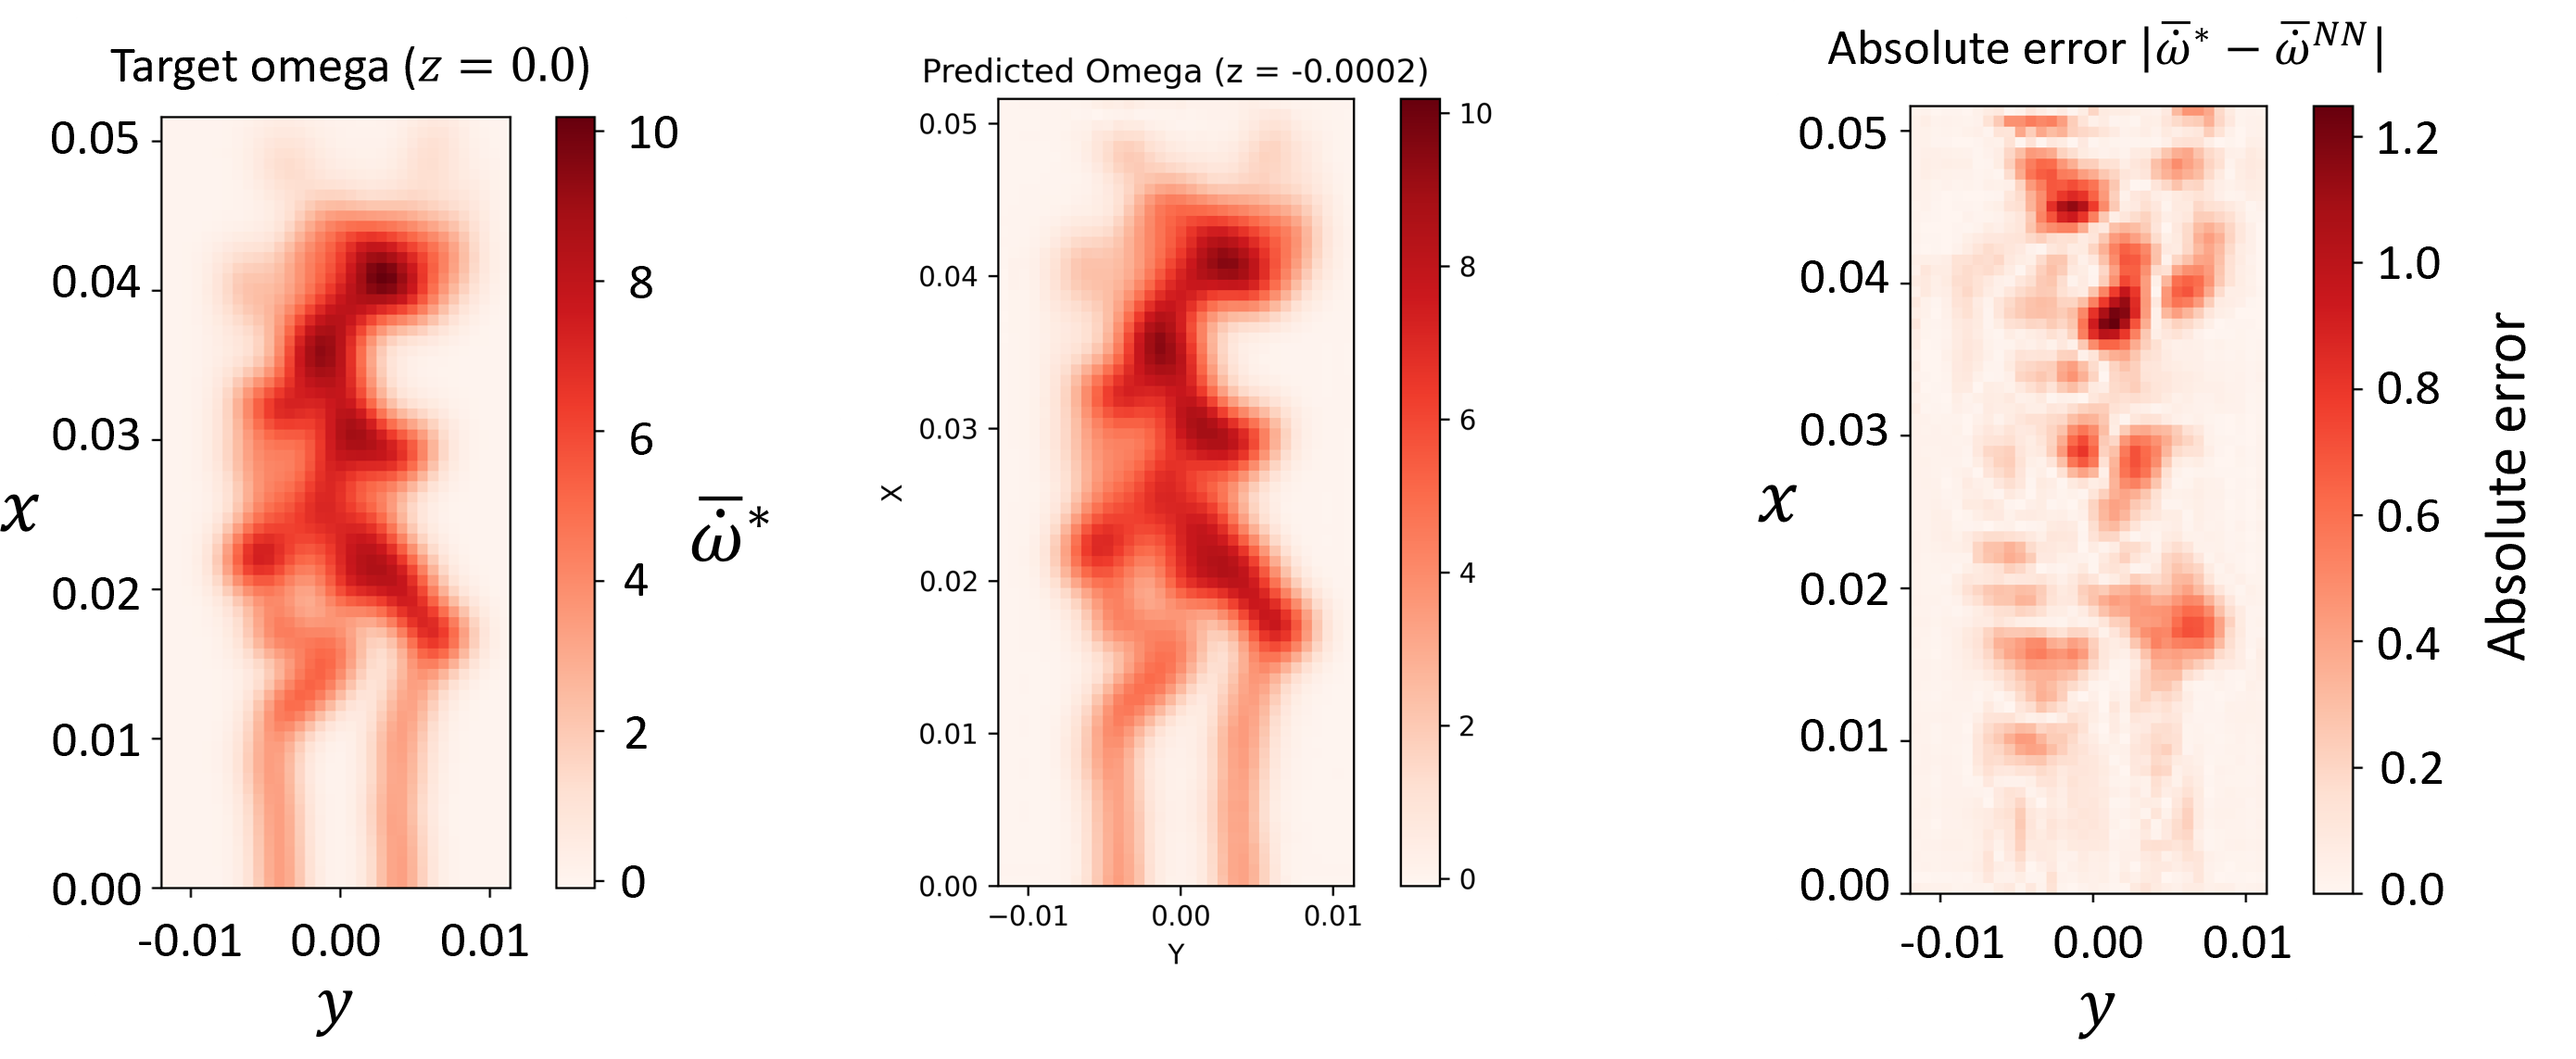
Tout récemment, des travaux exploratoires ont été menés sur un cas simplifié de combustion turbulente. Un modèle basé sur un réseau de neurones convolutif (CNN)1 a été entraîné à partir de simulations numériques directes (DNS) de la flamme, puis utilisé pour prédire le comportement de cette dernière sur des maillages plus grossiers.
Les résultats obtenus sont encourageants, comme l’illustre la figure 1, qui compare le taux de réaction exact ω (mol/s) avec la prédiction du modèle.
Ces travaux se poursuivent aujourd’hui dans le cadre d’une thèse IFPEN/ONERA débutée en 2026 [3].
1 Architecture d'apprentissage profond spécialisée dans le traitement des données structurées en grille, comme les images
Références :
[1] Sanderse, B., Stinis, P., Maulik, R., & Ahmed, S. E. (2025). Scientific machine learning for closure models in multiscale problems: A review. Foundations of Data Science, 7(1), 298–337.
>> DOI : https://doi.org/10.3934/fods.2024043
[2] Vital, E. et al. (2025), Neural Network for Subgrid Turbulence Modeling for Large Eddy Simulations. Proceedings of ParCFD 2025 conference,
>> DOI : https://arxiv.org/abs/2511.05103.
[3] Flament, C., Thèse ONERA/IFPEN: Modélisation du plissement de sous-maille par apprentissage automatique pour les simulations aux grandes échelles de la combustion turbulente prémélangée.
Contacts scientifiques : Cédric Mehl, Thibault Faney